
如果你現在打開 repo 看一下就會發現,我們手上這些東西其實只是六個各自為政的實驗腳本,每支都能跑,但沒有一支能被別人呼叫,但接下來要進入 Multi-Agent 的部分,對 Agent 來說 RAG 就只是它手上的一個工具而已,所以今天要做的事情就是把這堆腳本收成一個真正能被呼叫的工具。
這篇的完整程式碼一樣會放在 GitHub repo:https://github.com/AUSTIN2526/30-days-ironman-agent,可以直接下載下來執行。
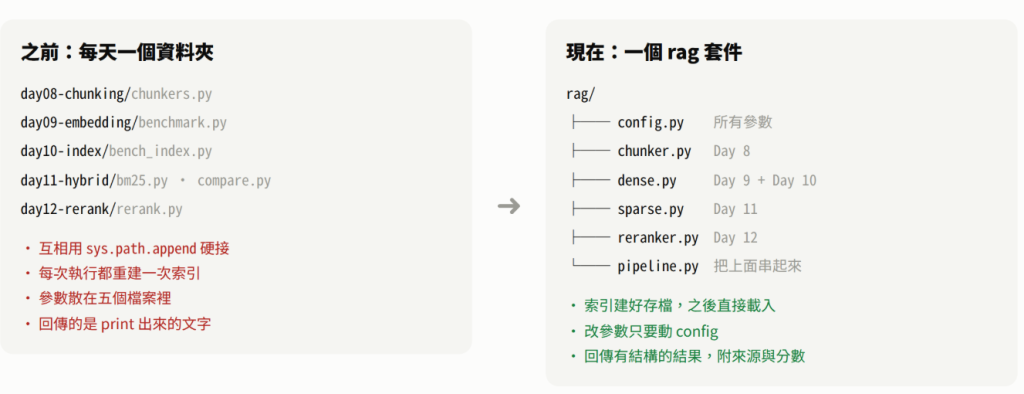
目前的狀況大概是這樣:Day 12 的 rerank.py 要用 sys.path.append 去接 Day 11 的 compare.py,而那支又去接 Day 8 的 chunkers.py,只要有人把資料夾改名就全部掛掉。
更麻煩的是每次執行都會重新建一次索引,因為索引根本沒有存下來,而真的上線時應該要能夠條用儲存好的索引值才對,另外超參數也非常的混亂,最後是回傳值的部分都是用 print顯示的,但工具要回傳的是可以被程式處理的資料,不是印在螢幕上的文字。
所以我們要第一件事是把散落各處的參數收進一個 dataclass,並且真的這個檔案我們還要設計一些防呆的方式。
# rag/config.py
@dataclass
class RAGConfig:
    """整條流程的設定集中在這裡,改參數不用到處翻程式碼。"""

    chunk_size: int = 120                                   # Day 8
    embed_model: str = "BAAI/bge-small-zh-v1.5"             # Day 9
    query_prefix: str = "为这个句子生成表示以用于检索相关文章:"
    rrf_pool: int = 3                                       # Day 11
    n_candidates: int = 10
    rerank_model: str = "BAAI/bge-reranker-base"            # Day 12
    rerank_threshold: float = 0.3
    top_k: int = 3
    llm_model: str = "Qwen/Qwen2.5-1.5B-Instruct"           # Day 7

    def fingerprint(self) -> str:
        """凡是會影響索引內容的設定,都要記進指紋裡,載入舊索引時才比對得出來。"""
        return f"{self.chunk_size}|{self.embed_model}|{self.doc_prefix}"
前幾天我們一直在強調換模型、換切塊策略就要重建索引,但實際上最容易出事的情況是你改了參數卻忘記重建,這時候你會發現檢索結果莫名其妙變爛,然後找了半天發現自己犯蠢了恩對這就是我。
所以我把會影響索引的三個設定串成一段指紋,存檔時一起寫進去,載入時比對不上就直接擋下來這也就是fingerprint()的實際用處,而之後如果要使用我們可以用以下程式碼去檢測
if meta["fingerprint"] != self.config.fingerprint():
    raise ValueError(
        f"索引是用不同的設定建的,請重新建立索引\n"
        f"  索引裡的設定:{meta['fingerprint']}\n"
        f"  現在的設定 :{self.config.fingerprint()}"
    )
這樣與其之後花半天查為什麼檢索變差,不如在載入的當下就讓程式告訴你比較快。
接著是把索引存到硬碟,這樣服務啟動時直接載入就好,不過這裡有一個決定要說明,就是 BM25 我沒有存,載入時直接用 chunks 重建:
def save(self, path):
    faiss.write_index(self.index, str(path / "vectors.index"))
    with open(path / "meta.pkl", "wb") as f:
        pickle.dump({"chunks": self.chunks, "fingerprint": self.config.fingerprint()}, f)

def load(self, path):
    self.dense.load(path)
    self.sparse = BM25(self.dense.chunks)   # BM25
    return self
這麼做的理由也很簡單,因為BM25 只是統計詞頻,13 塊在幾毫秒內就算完了,就算是幾萬塊也不過幾秒鐘,存檔反而多一份要維護的東西。而向量就不一樣了,那是模型算出來的,重算一次要花的時間跟錢完全是另一個等級,這種運算很緩慢的東西才值得存,另外模型本身也不要在物件建立時就載入,改成第一次真的要用時才載:
@property
def model(self):
    if self._model is None:
        from sentence_transformers import SentenceTransformer
        self._model = SentenceTransformer(self.config.embed_model)
    return self._model
這樣如果 Agent 這一輪根本沒呼叫到 RAG 工具,就不會白白吃掉幾百 MB 的記憶體。
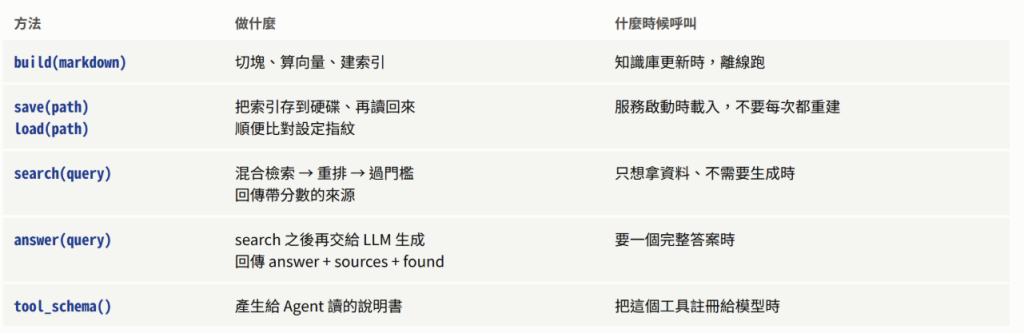
接下來我們要定義之後想要使用的整個 RAGPipeline 對外方法,就像圖片中的這樣我把方法與內容都寫在上面,但這裡有兩個設計上的選擇想多講一下,第一個是為什麼 search() 和 answer() 要分開。
因為在實際 Agent 中有時候只是想把原始資料撈出來,自己決定要怎麼用,不見得每次都需要一段生成好的文字,而生成又是整條流程裡最慢最貴的一段,硬綁在一起只是浪費Token。
第二個是回傳值要有結構,其中我定義sources 是為了讓答案能追溯回原文,這是為了處理幻覺所需要用的方式,而 found 則是接續昨天的門檻,檢索不到夠格的內容時就直接回答查不到,不讓模型亂說一通。
@dataclass
class Source:
    """每一筆來源都要能回答:這段話是從哪裡來的、有多相關。"""
    content: str
    score: float
    chunk_id: int


@dataclass
class RAGResult:
    answer: str
    sources: list[Source]
    found: bool          # 有沒有檢索到夠格的內容,沒有的話 answer 就是查不到
sources = self.search(query)
if not sources:
    # 檢索不到就不要浪費一次生成,直接回答查不到
    return RAGResult(answer="查不到相關資訊。", sources=[], found=False)
最後讓我們來試試看這幾天做出來的東西實際上線會出現什麼結果,注意一點建索引和查詢現在是分開的兩支程式,這也比較接近實際部署的樣子,先讓我們建立知識庫:
python build_index.py # 知識庫更新時才需要跑
接下來我們跑一次 demo.py,而這裡我特別放了一題手冊裡根本沒有的問題,看它會不會老實說查不到:
QUESTIONS = [
    "我年資三年可以請幾天特休?",
    "爸爸住院我想請假陪他,公司有這種假嗎?",
    "HR-017 是什麼表單?",
    "公司有附健身房嗎?",          # 手冊裡根本沒有,看它會不會老實說查不到
]
問題:我年資三年可以請幾天特休?
回答:可以請 14 天特休。
耗時:34.2 秒 找到資料:True
  [1] 1.00 【請假制度 > 特休】員工到職滿半年可請 3 天特休。年資滿一年可請 7 天特休…
  [2] 0.35 【家庭照顧】員工的配偶、父母或子女需要親自照顧時,可以申請家庭照顧假,全年合計最…

問題:爸爸住院我想請假陪他,公司有這種假嗎?
回答:查不到。
耗時:0.3 秒 找到資料:True
  [1] 0.43 【家庭照顧】員工的配偶、父母或子女需要親自照顧時,可以申請家庭照顧假,全年合計最…
  [2] 0.32 【請假制度 > 病假】員工因病需要請假時,一年內累計不超過 30 天的部分薪資折…

問題:HR-017 是什麼表單?
回答:HR-017 是差旅申請單。
耗時:0.5 秒 找到資料:True
  [1] 0.65 【報帳流程 > 差旅費用】出差前需要填寫 HR-017 差旅申請單,並取得部門經…

問題:公司有附健身房嗎?
回答:查不到相關資訊。
耗時:0.0 秒 找到資料:False
在這邊看到我們專注的最後一題,健身房在手冊裡完全不存在,所以重排分數全部低於門檻,found 直接是 False,連生成都沒有跑,這就是昨天那個門檻真正的價值,它不只是讓 Prompt 乾淨,還省下一整次完全沒必要的生成,但是注意一下要這樣處理是因為我們針對問題集進行分析,所以才能過濾得更乾淨,如果真實的系統中這個值測試出來後還是要放寬一些條件以免遇到特殊狀況而無法調整。
而第二題才是今天最值得看的地方,爸爸住院那題,檢索其實完全正確,家庭照顧那塊以 0.43 排在第一,found 也是 True,資料就好好地躺在 Prompt 裡面,但 Qwen2.5-1.5B 看完之後,回了我一句查不到。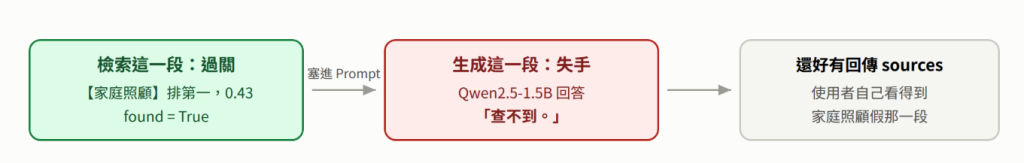
原因是手冊寫的是配偶、父母或子女需要親自照顧,而模型沒有把爸爸住院這件事連到父母這個詞上,同一題在 Day 12 的重排分數裡也看得出來,0.43 其實不算高分,代表連 reranker 都覺得有點勉強,只是它還是把正解排到第一而已。
但最大的問題是說到底,1.5B 的模型就是這個等級,我們選它是因為一般電腦跑得動,但它的推理能力本來就有限,當我們把模型的參數用大一點模型甚至能過自動過濾錯誤的RAG提示,這件事帶出一個很重要的觀念,就是評估 RAG 的時候一定要把檢索和生成分開看。
如果只看最後那句回答,你會以為是檢索壞掉,然後回頭去亂調 chunk_size 或換 Embedding 模型,結果調了半天都沒用,因為問題根本不在那裡,而這也正是我們讓 RAGResult 回傳 sources 的價值,就算生成失手,使用者點開來源還是找得到答案,而不是只看到一句冷冰冰的查不到,至於怎麼讓小模型乖乖照著資料回答,那就要回到之前講過的微調了,這個系列後面會再處理。
到這裡我們手上終於有一個完整的工具了,但它現在還是要我們自己寫死在程式裡呼叫,所以明天開始要進入這個系列真正的主題,也就是讓模型自己決定什麼時候該呼叫這個工具,這就是 Function Calling 或者說 Tool Use。而這也是 Agent 和一般聊天機器人最根本的差別,那我們明天再見!


 iThome鐵人賽
 看影片追技術